Engage with AI 2 · Grundlegend
Warum sind gute Trainingsdaten wichtig?
Wie zuverlässig KI-Systeme später arbeiten, hängt von vielen Faktoren ab:
- Anzahl der Daten
- Gewählte Trainingsmethode
- Qualität der Trainingsdaten
- Vielfalt der Trainingsdaten
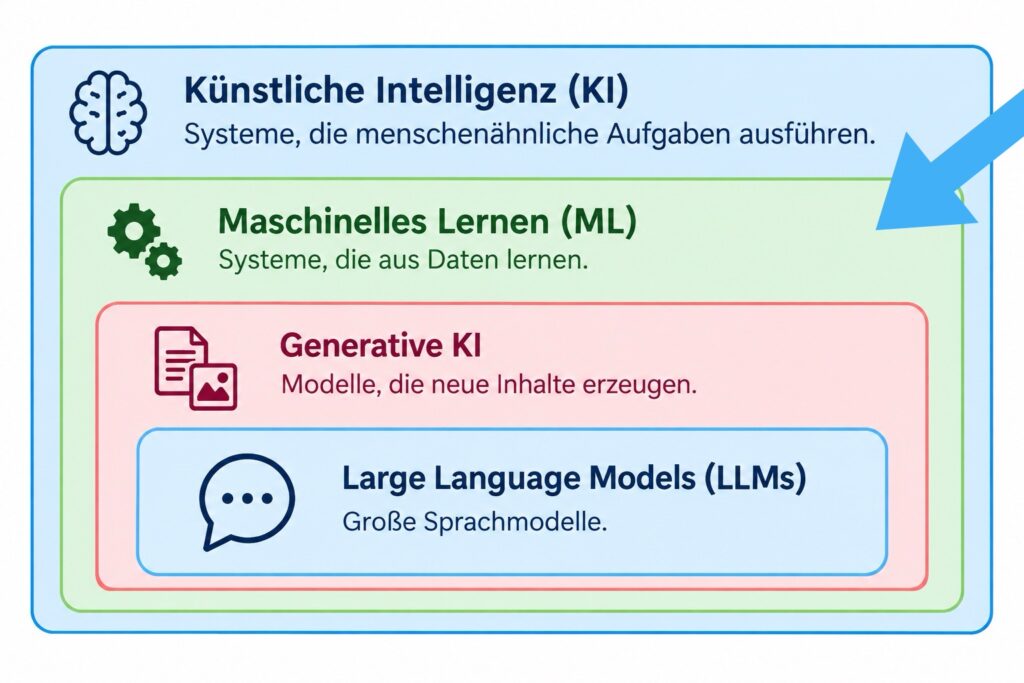
Selbst gut trainierte KI-Systeme erreichen in der Praxis selten eine 100-prozentige Treffsicherheit.
📝 Beispiel 1 – Abweichungen in der Realität
Ein Grund ist, dass sich die Daten in der Realität von den Trainingsdaten unterscheiden können, beispielsweise ein schlecht aufgenommenes Handyfoto. Je stärker sich diese von den Trainingsdaten unterscheiden, desto größer ist das Risiko, dass das KI-System Fehler macht. Diese Problematik wird auch als Domain Shift bezeichnet.
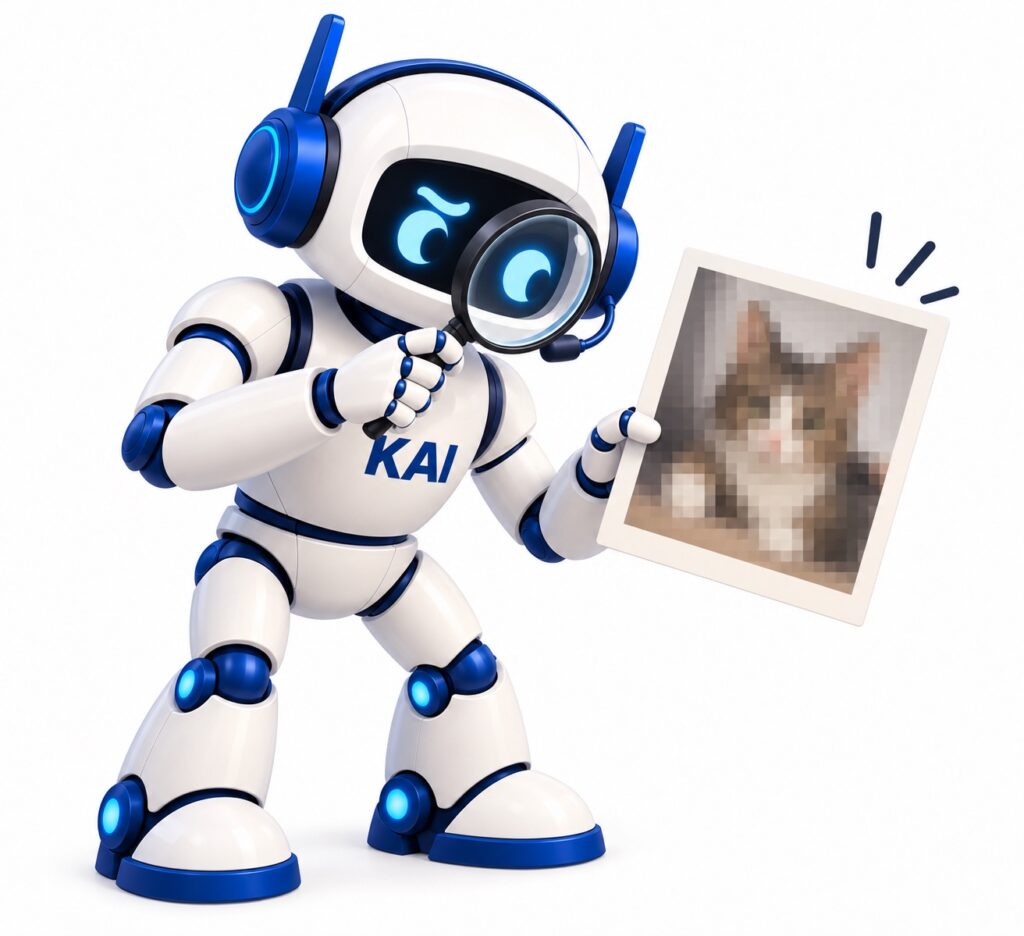
Hmm, ist das jetzt eine Katze? Ich brauche dringend eine bessere Kamera für meine Fotos.
📝 Beispiel 2 – Unvollständige Trainingsdaten
Ein Beispiel aus der Gesichtserkennung: Damit ein KI-System Gesichter zuverlässig erkennen kann, muss es mit vielen unterschiedlichen Gesichtsbildern trainiert und getestet werden. Sind bestimmte Gruppen in den Trainingsdaten nur wenig vertreten, kann das System bei deren Gesichtern häufiger Fehler machen. Solche Verzerrungen werden auch als Bias bezeichnet. Mehr dazu im nächsten Kapitel.
Lass uns auf der nächsten Seite einen Schritt weiter gehen. Noch wissen wir nicht genau, was ein Large Language Model macht oder wie es funktioniert.
Auf der nächsten Seite schauen wir die Generative KI einmal genauer an.