Wie funktioniert eine semantische Suche bei RAG?
Auf der vorherigen Seite haben wir gesehen, dass eine semantische Suche nicht nur nach gleichen Wörtern sucht. Sie versucht, Textstellen zu finden, die inhaltlich zu einer Frage passen.
Hierzu brauchen wir in unserem KI-System ein paar weitere Schritte, die das Ganze etwas komplizierter machen.
Chunking – Warum werden Dokumente in kleine Abschnitte zerlegt?
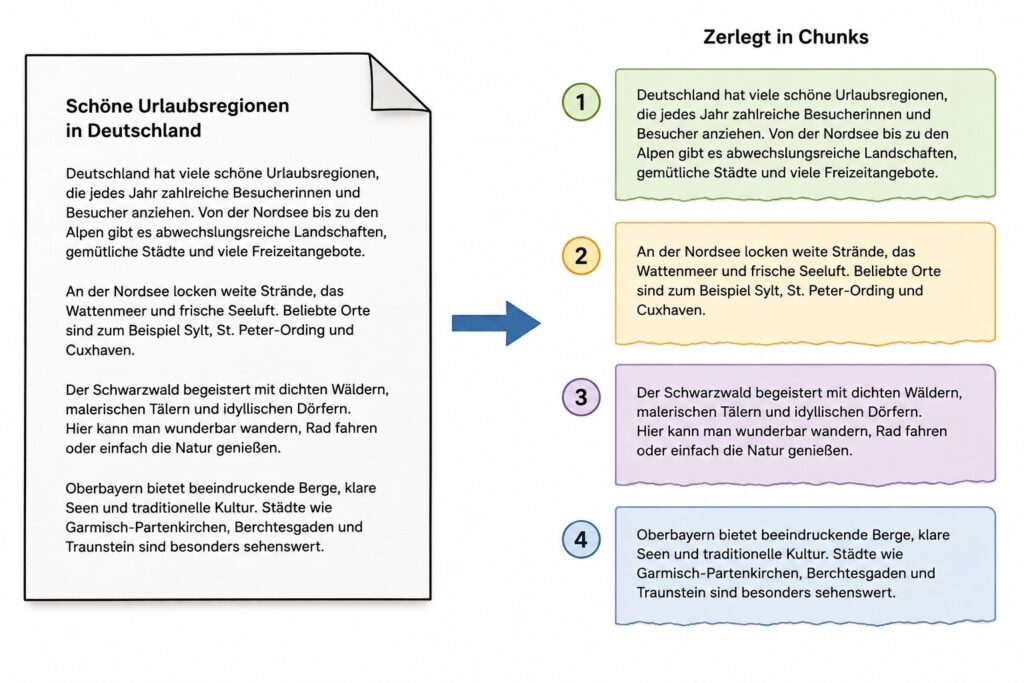
Zunächst wird ein Dokument, z. B. eine Textseite, in kleinere Textabschnitte zerlegt. Warum macht man das?
Denke nochmals an die Frage der Schülerin in unserem Eingangstext zu RAG:
Die Schülerin stellte dort die Frage: „Welche Sehenswürdigkeiten gibt es in der Stadt Traunstein in Oberbayern?“
Es war wenig sinnvoll, jedes Mal das gesamte Buch an das Sprachmodell weiterzugeben. Für die Antwort benötigen wir eigentlich nur die Textstellen, in denen es um Oberbayern, genauer gesagt um Traunstein ging.
Eine zweite KI (genauer: ein spezielles Embedding-Modell) analysierte daher die Frage und sucht in dem Urlaubsbuch die geeigneten Textstellen (Chunks) heraus. Dann sendet der Chatbot diese Textstellen an das LLM.
Deshalb werden Dokumente bei vielen RAG-Systemen in kleinere Textabschnitte zerlegt. Diese Textabschnitte nennt man Chunks.
💡 Merke
Ein Chunk ist ein kleiner Abschnitt eines größeren Dokuments. Statt immer das gesamte Dokument zu verwenden, kann ein RAG-System gezielt nach den Chunks suchen, die für eine Frage relevant sind.
Was passiert mit den Chunks?
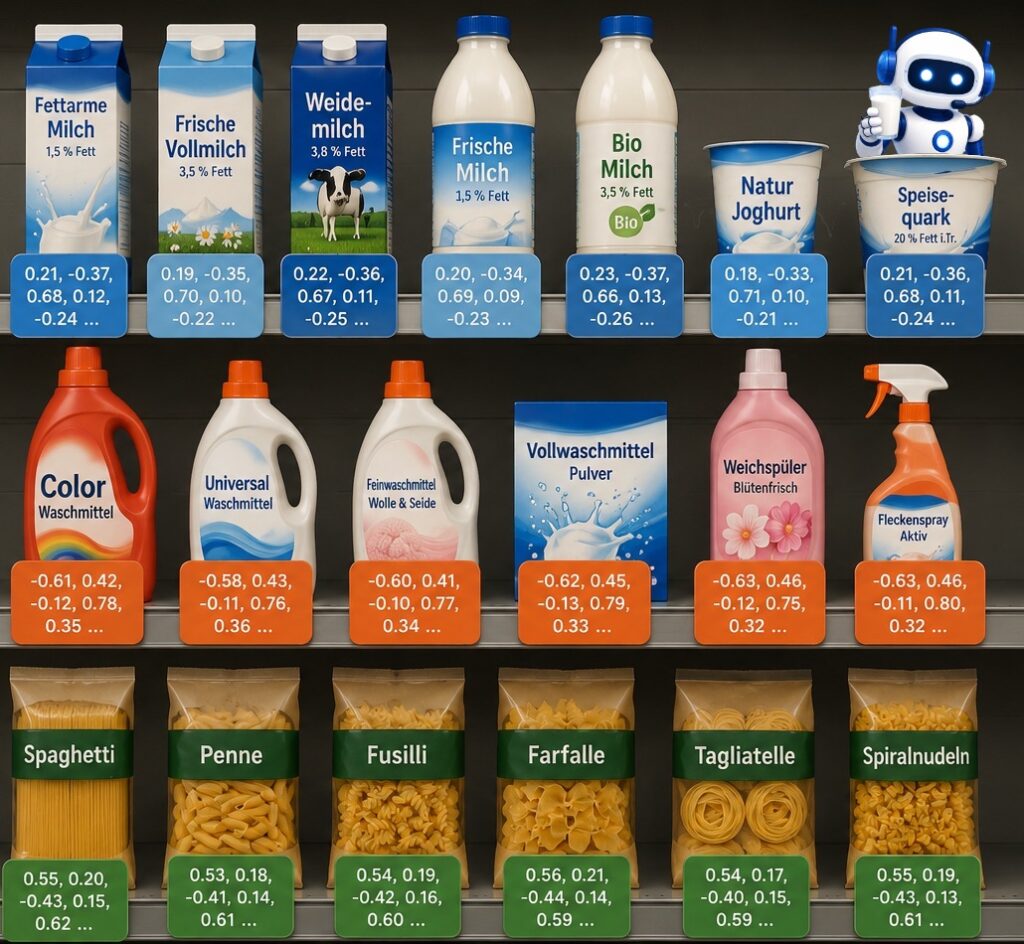
Stell dir vor, du arbeitest in einem Supermarkt und klebst auf jedes Produkt ein Etikett. Jedes Produkt erhält ein besonderes Zahlenetikett. Dieses Etikett ist so aufgebaut, dass ähnliche Produkte auch ähnliche Zahlenetiketten bekommen. Alle Milchprodukte, Milch, Joghurt oder Quark, würden dadurch ähnliche Zahlenetiketten haben. In dem Bild haben sie blaue Etiketten. Sie unterscheiden sich stark von den Etiketten für Waschmittel und Nudeln. Anschließend stellst du alle Produkte in ein Regal. Du kannst nun alle Milchprodukte anhand des Etiketts wiederfinden, auch wenn sie an unterschiedlichen Stellen im Regal stehen.
Ähnlich macht es nun auch eine besondere KI, ein sogenanntes Embedding-Modell. Jeder Textabschnitt (Chunk) bekommt gewissermaßen ein solches Etikett. Das Embedding-Modell versucht, den Inhalt des Textabschnitts zu erfassen und erstellt dazu eine solche Zahlenliste.
Mit diesen Zahlen kann das System gut arbeiten. In der Realität sind das sehr lange Zahlenlisten, sogenannte Vektoren. Vektoren kennst du vielleicht noch aus dem Mathematikunterricht. Ein stark vereinfachtes Beispiel könnte so aussehen:
[0.18, -0.42, 0.73, 0.05, -0.31, 0.62, 0.11, ...]
Vereinfacht gesagt repräsentiert dieser Vektor bestimmte inhaltliche Merkmale des Textabschnitts. Vektoren ähneln sich, wenn es inhaltlich um ähnliche Dinge wie beispielsweise Photosynthese geht.
Eine Vektordatenbank nimmt den Textabschnitt zusammen mit dem Vektor entgegen und speichert ihn fein säuberlich ab; ähnlich wie du die Milchpackung mit dem Etikett in das Regal gestellt hast.
Wie findet das System die passenden Chunks?
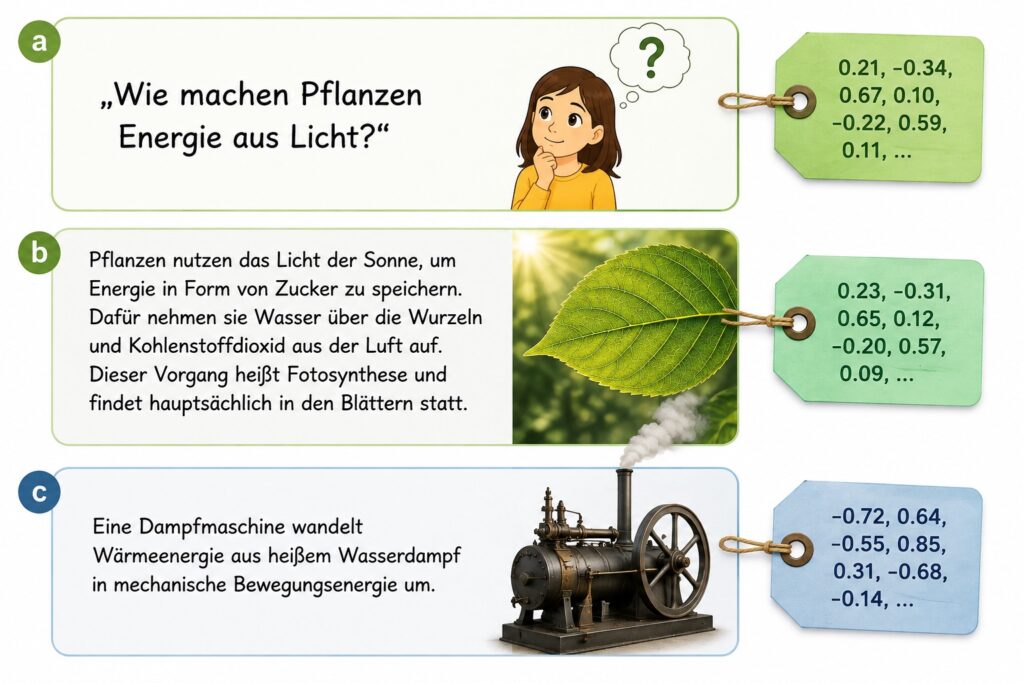
Auch die Frage der Nutzerin in unserem Beispiel auf der vorherigen Seite des Exkurses „Wie machen Pflanzen Energie aus Licht?“ wird entsprechend verarbeitet. Sie bekommt ebenfalls einen Vektor (in dem Bild das grüne Etikett).
Nun kann das System diesen Vektor mit den Vektoren in der Vektordatenbank vergleichen. Es sucht nach ähnlichen Vektoren (in dem Bild sucht es nach anderen grünen Etiketten). So lassen sich die Textabschnitte (Chunks) finden, die inhaltlich besonders gut zur Frage passen.
📝 Betrachten wir ein stark vereinfachtes Beispiel
Die Schülerin fragt also:
„Wie machen Pflanzen Energie aus Licht?“
Ein Embedding-Modell erstellt daraus einen Vektor, der stark vereinfacht für Photosynthese steht, obwohl dort nicht unbedingt dieses Wort vorkommt. [0.21, -0.34, ...]
Das Embedding-Modell hat einfach versucht, den Sinn der Frage zu erfassen.
Das System vergleicht nun den Vektor der Frage mit den gespeicherten Vektoren und sucht nach besonders ähnlichen Vektoren, also nach Textabschnitten über Photosynthese.
Es findet folgenden Textabschnitt:
„Pflanzen nutzen das Licht der Sonne, um Energie in Form von Zucker zu speichern. Dafür nehmen sie Wasser über die Wurzeln und Kohlenstoffdioxid aus der Luft auf. Dieser Vorgang heißt Fotosynthese und findet hauptsächlich in den Blättern statt.“ [0.23, -0.31, ...]
Und was passiert mit den gefundenen Chunks?
Die passenden Textabschnitte (Chunks) werden anschließend dem Large Language Model zusammen mit der Frage als zusätzlicher Kontext zur Verfügung gestellt. Den Vektor selbst bekommt das LLM nie zu Gesicht.
Das LLM erhält damit neben der eigentlichen Frage auch passende Informationen aus der Wissensbasis. Auf dieser Grundlage formuliert es seine Antwort.
Bei einem typischen RAG-System arbeiten daher ganz unterschiedliche Komponenten zusammen:
- Das Embedding-Modell übersetzt die Textabschnitte und die Frage in Vektoren.
- Die Vektordatenbank und die Logik dahinter speichern die Vektoren und helfen dabei, passende Textabschnitte wiederzufinden.
- Das Large Language Model erhält diese Textabschnitte anschließend als Kontext und formuliert daraus eine Antwort.
Das Embedding-Modell hilft beim Suchen. Das Large Language Model hilft beim Antworten.
⚠️ Wichtig
Ein RAG-System kann helfen, Antworten auf eine ausgewählte Wissensbasis zu stützen. Es garantiert aber keine fehlerfreien Antworten.
1) Die Suche kann unpassende Informationen finden:
Dann erhält das Sprachmodell möglicherweise nicht die Textstellen, die es für eine gute Antwort benötigt.
2) Das Sprachmodell kann die gefundenen Informationen falsch verarbeiten:
Auch mit einer guten Wissensbasis bleibt das LLM ein Sprachmodell, das auf Grundlage des bereitgestellten Kontexts eine Antwort generiert.