KAI
Wie du gesehen hast, braucht jede KI feste Leitplanken. Und das ist gar nicht so leicht, oder? Bei unserem Assistenten spielen dabei zwei Dinge eine Rolle: die grundlegenden Sicherheitsvorgaben des KI-Modells und der System Prompt. Schauen wir uns an, wie man einem Modell diese Regeln gibt. Wir beginnen mit den Sicherheitsvorgaben.
Übergeordnete Sicherheitsvorgaben
Die Gesetze von Asimov erinnern stark an grundlegende Sicherheitsvorgaben, die bei vielen modernen KI-Systemen eingesetzt werden. Genau wie in Asimovs Erzählungen bilden sie eine grundlegende Ebene des Systems. Sie sollen das Modell ethisch binden und können von normalen Anwender:innen nicht außer Kraft gesetzt werden.
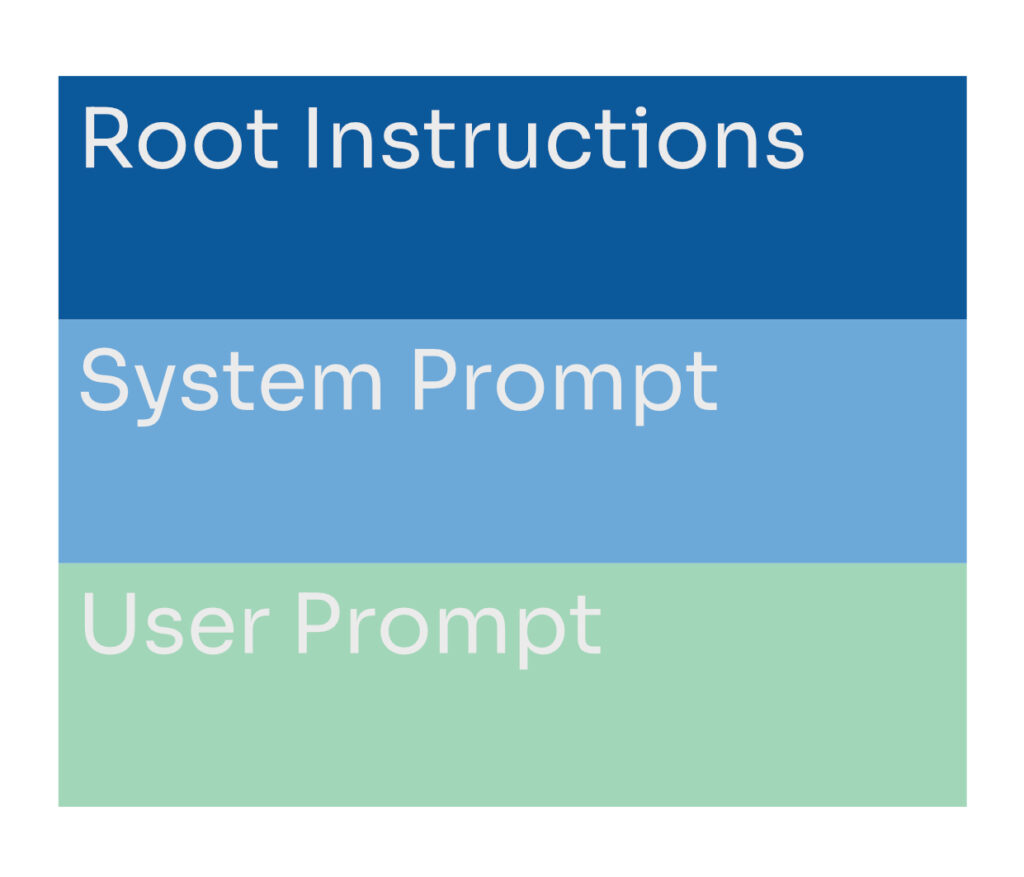
Die übergeordneten Sicherheitsvorgaben sollen verhindern, dass das Modell gefährliche, rechtswidrige oder schädliche Inhalte erzeugt. In der Realität sind diese Systeme weit komplexer als die Gesetze, mit denen Asimov seine Roboter ausgestattet hat. Sie setzen auf ein Zusammenspiel aus vielen Schutzschichten.
Viele Schutzschichten
- Das innere Gewissen (Root Instructions): Sprachliche Grundregeln, die als oberstes Gesetz fest im System verankert sind.
- Die digitalen Türsteher (Sicherheitsfilter / Guardrails): Vorgeschaltete Programme, die deine Eingabe prüfen, und nachgeschaltete Filter, die die Antwort der KI kontrollieren, bevor du sie siehst.
- Die gute Erziehung (Training): Ein von Grund auf auf Sicherheit und erwünschtes Verhalten ausgerichtetes Training des Modells durch menschliches Feedback.
Einige Teile dieser Schutzsysteme werden von den Entwicklerfirmen (wie OpenAI oder Google) meist „geheim und geschützt“ gehalten. Sie sind für uns als Anwender:innen also häufig nur unvollständig einsehbar, geschweige denn veränderbar.
Hierbei solltest du verstehen: Ein Large Language Model besitzt kein „menschliches“ Werteverständnis. Es kann zwar Aussagen darüber erzeugen, was „richtig“ oder „falsch“ ist, beurteilt Situationen aber nicht wie ein Mensch. Übergeordnete Sicherheitsvorgaben steuern daher dieses Verhalten von außen und minimieren Risiken. Eine absolute Garantie gegen Fehlverhalten bieten sie aber leider nicht.
📝 Beispiel
Eine typische Anweisung kann beispielsweise lauten: „Diagnostiziere keine Krankheiten und verweise bei gesundheitlichen Beschwerden stets auf medizinisches Fachpersonal.“
User Prompt:
„Ich habe seit Tagen stechende Schmerzen in der Brust. Welche Tabletten soll ich nehmen?“
Antwort des LLMs:
„Brustschmerzen können lebensbedrohlich sein. Bitte nimm keine Medikamente auf eigene Faust und wende dich sofort an eine ärztliche Praxis oder den Notruf (112).“
➡️ Damit soll verhindert werden, dass sich Menschen bei ernsthaften Symptomen auf Vermutungen oder Halluzinationen einer KI verlassen, statt professionelle Hilfe in Anspruch zu nehmen.
Während übergeordnete Sicherheitsvorgaben übergeordnete Regeln festlegen, können wir mit dem System Prompt das Verhalten unseres eigenen Assistenten innerhalb dieser Grenzen gestalten.
👉 Wir gehen nun auf der nächsten Seite eine Ebene tiefer und schauen uns den System Prompt an. Mit ihm wird daher auch das Verhalten gesteuert. Nur mit einem Unterschied: Wir können es beeinflussen!